从零开始的 AI Infra: 算子基础与GPU架构
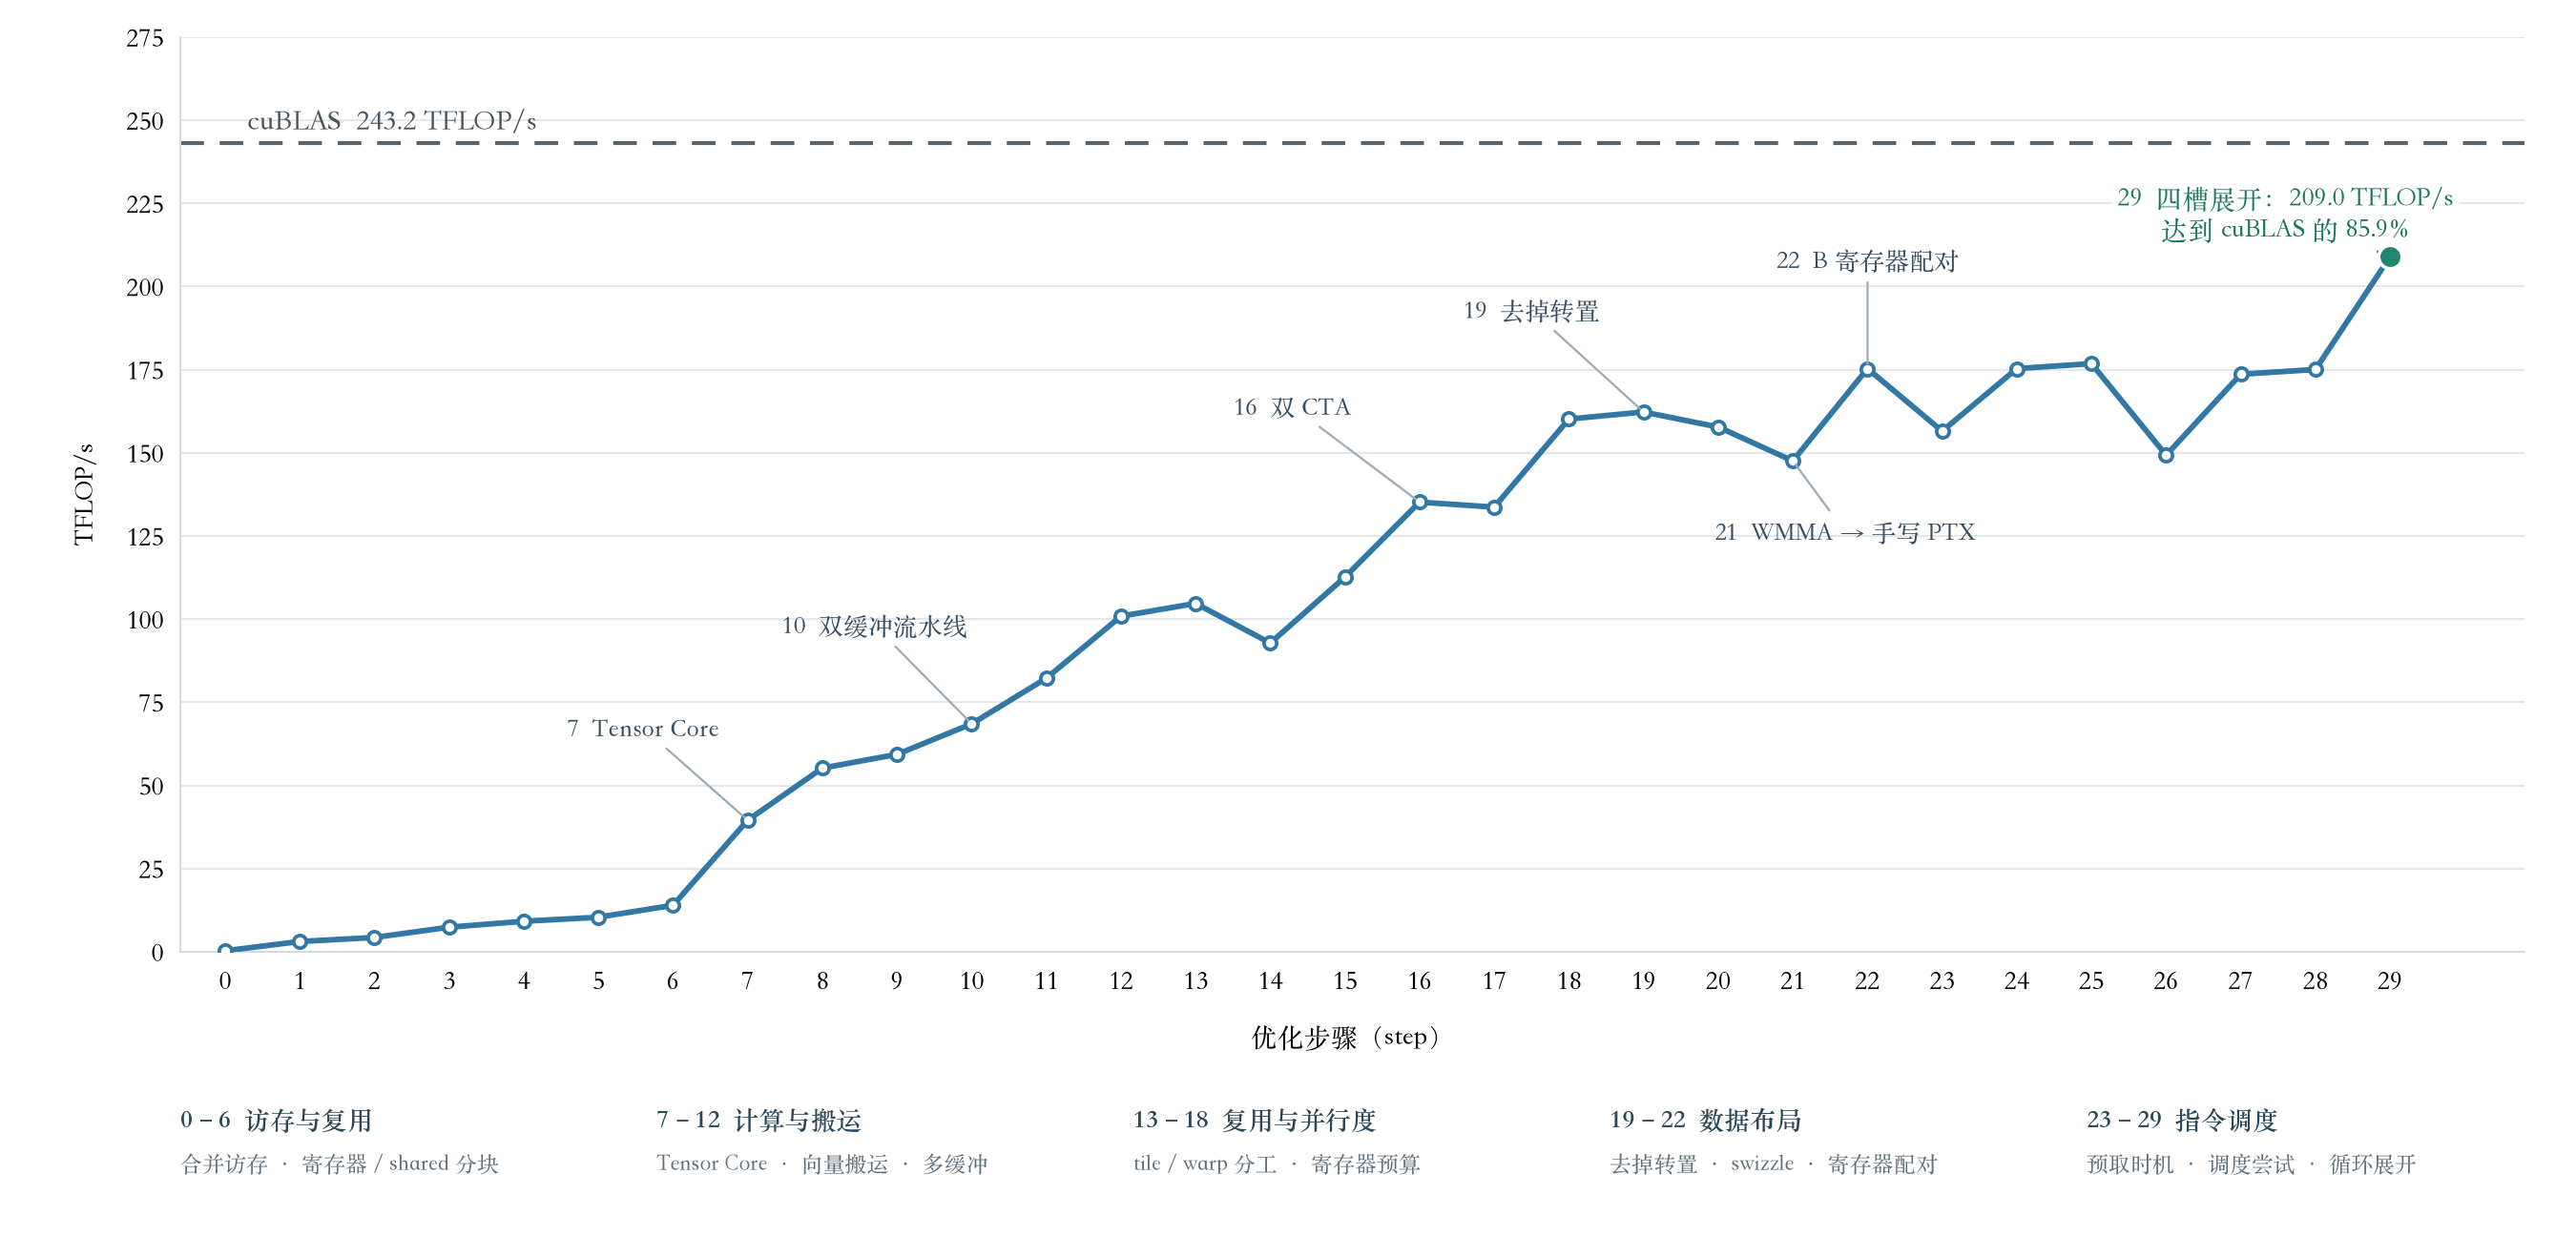
摘要:本文借由 NVIDIA A800 上 GEMM 矩阵乘法的逐步调优,向读者介绍 CUDA 编程和 GPU 硬件的基础知识与优化技术。从最朴素的实现开始,我们沿着访存地址、数据复用和 profiling 结果,逐步引入寄存器分块、shared memory、Tensor Core 和异步流水线,最后深入到寄存器布局与指令安排。朴素版耗时约为 cuBLAS 的 837 倍,最终版的吞吐达到了 cuBLAS 的 85.9%。所有源代码放在:Qi-Zhan/gemm_tutorial。
背景与分析
矩阵乘法是大模型中最基础、也最常见的运算之一。Transformer 里的 Q、K、V 投影,注意力分数的计算,以及前馈网络中的线性变换,都离不开它。它恰好也是一个很适合深入 GPU 编程的例子:公式简单,三层循环就能算对;但想获得较高的性能,却要认真考虑线程分工、数据复用、计算与搬运怎配合等问题。
这次我们用的是 A800,和 A100 同属 Ampere(SM80)架构(因为我搞不到更新的卡 :( ),从下面这个矩阵乘法开始:
\[C_{M\times N}=A_{M\times K}B_{N\times K}^{\mathsf T}, \qquad M=N=5376,\ K=2048.\]首先来分析一下计算量:C 一共有 \(MN\) 个元素,每个元素沿 K 累加,代码中执行 K 次乘加。一次乘加包含一次乘法和一次加法,计为 2 FLOP,所以整个矩阵乘法的计算量是:
\[\mathrm{FLOPs}=MN\times K\times2=2MNK =2\times5376\times5376\times2048 =118{,}380{,}036{,}096 \approx118.38\ \mathrm{GFLOP}.\]再除以执行时间,就得到吞吐量。若时间用毫秒表示:
\[\mathrm{TFLOP/s}=\frac{2MNK}{t_{\mathrm{ms}}\times10^9}.\]因此,同样这次 GEMM 用了 1 ms,吞吐量就是 118.38 TFLOP/s;用了 0.5 ms,就是 236.76 TFLOP/s。后面的优化始终计算同一个结果,减少的是完成它所需的时间。
Baseline
当然平时在 PyTorch 中做 GPU 矩阵乘法,我们不需要自己写算子,框架会调用 cuBLAS 等底层库。cuBLAS 是 NVIDIA 提供的 GPU 线性代数库,其中的矩阵乘法已经做了大量优化,正好可以作为这次的 baseline。
我们调用 cublasGemmEx 计算同一个 \(C=AB^{\mathsf T}\)。这个尺寸下,cuBLAS 耗时约 0.487 ms,对应 243.2 TFLOP/s,也就是图中那条水平虚线。
0. Naive Implementation
根据定义,我们可以得到矩阵乘法最直接的写法,就是一个三重循环:
for (int m = 0; m < M; ++m)  // M 维:输出行
    for (int n = 0; n < N; ++n) {  // N 维:输出列
        float acc = 0;
        for (int k = 0; k < K; ++k)  // K 维:点积累加
            acc += float(A[m*K+k]) * float(B[n*K+k]);
        C[m*N+n] = half(acc);
    }
不难看出每个 C[m,n] 都可以独立计算。我们可以很自然的让它们并行计算。而 GPU 擅长同时处理大量这样的工作:线程运行同一段代码,通过各自的编号处理不同的数据。
在 CUDA 中,这段交给 GPU 执行的函数叫 kernel。CPU 发起一次 kernel 调用,会启动许多 thread(线程);线程被分成若干 block(线程块),这些 block 合起来组成一个 grid(网格)。
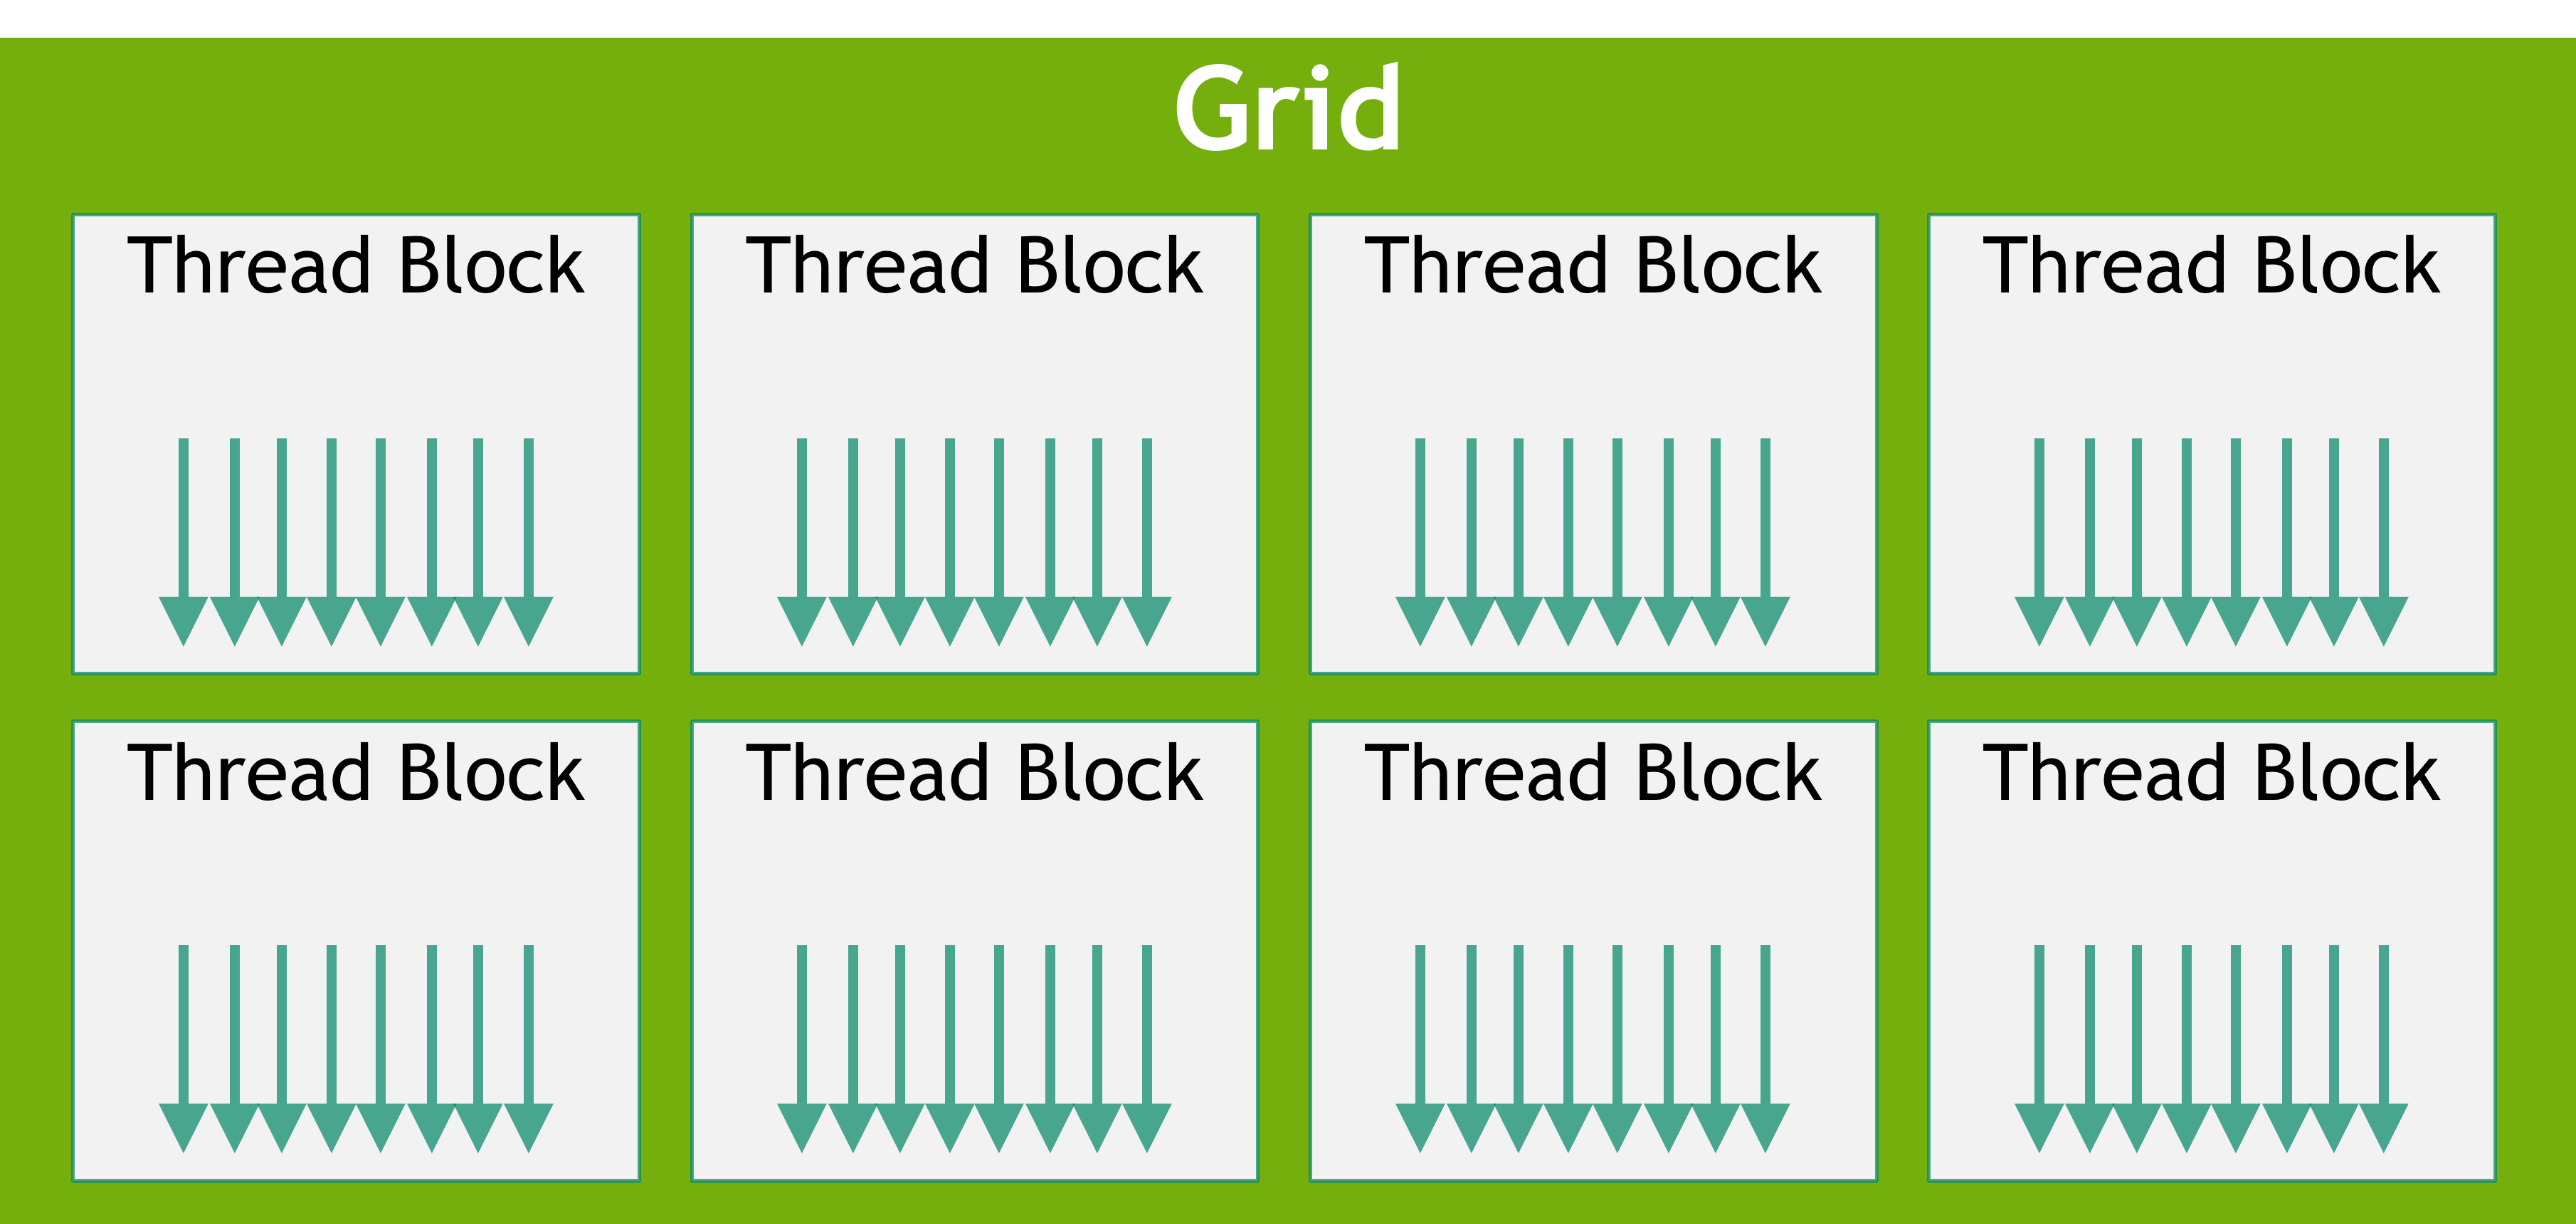
来源:NVIDIA CUDA Programming Guide。
对应到这个 GEMM,我们先让一个线程计算一个 C[m,n]。一个 block 放 (32,8),共 256 个线程,负责输出的 8 行、32 列;再用足够多的 block 覆盖整个 C 矩阵。每个线程先访问内存得到数值,再用自己的 acc 累加结果:
__global__ void gemm_naive(const half* A, const half* B, half* C,
                           int M, int N, int K) {
    int n = blockIdx.x * 32 + threadIdx.x;  // 当前线程的输出列
    int m = blockIdx.y * 8  + threadIdx.y;  // 当前线程的输出行
    if (m >= M || n >= N) return;

    float acc = 0.0f;
    for (int k = 0; k < K; ++k)  // K 维:点积累加
        acc = fmaf(__half2float(A[m*K+k]), // Fused Multiply-Add
                   __half2float(B[n*K+k]), acc);
    C[m*N+n] = __float2half_rn(acc);
}

// CPU 端调用;d_A、d_B、d_C 指向 GPU 内存
void launch_gemm(const half* d_A, const half* d_B, half* d_C,
                 int M, int N, int K) {
    dim3 block(32, 8);                      // 每块:32 列 × 8 行线程
    dim3 grid((N + 31) / 32, (M + 7) / 8); // 沿列、行方向向上取整
    gemm_naive<<<grid, block>>>(d_A, d_B, d_C, M, N, K);
}
<<<grid, block>>> 依次指定有多少个线程块、每个块有多少线程。这里 M=N=5376,对应 grid=(168,672)。
其中 blockIdx 表示当前 block 的编号,threadIdx 表示线程在 block 内的位置,两者构成了这个线程负责的全局坐标,如图所示:
整个 C 矩阵:
        block(0,0)   block(1,0)   ...
        block(0,1)   block(1,1)   ...
        ...

一个 32×8 线程的 block:
         n0    n1    n2    ...   n31
m0       t0    t1    t2    ...   t31
m1       t32   t33   t34   ...   t63
...
m7       t224  t225  t226  ...   t255
这个朴素版算一次要 407.47 ms,耗时约为 cuBLAS 的 837 倍,吞吐仅 0.291 TFLOP/s。任重而道远。
1. 内存结构与访存优化
慢了八百多倍,究竟慢在哪里呢?我们先用 Nsight Compute(ncu) 看一下。它会采集单个 kernel 内部的硬件计数器,告诉我们计算、访存等环节各种各样的信息。
| 硬件部分 | 相对峰值的吞吐 |
|---|---|
| 计算部分(SM) | 5.97% |
| L1/TEX 片上访存路径 | 98.44% |
| DRAM 显存 | 0.09% |
计算部分很闲,L1/TEX 却几乎忙满了,为什么 DRAM 只有 0.09%?这就要看 GPU 的存储层次(memory hierarchy)。和 CPU 类似,GPU 在计算单元和显存之间也放了缓存:每个 SM(GPU 的计算单元)附近有 L1,多个 SM 共享 L2,再往外才是存放 A、B 的 DRAM 显存。
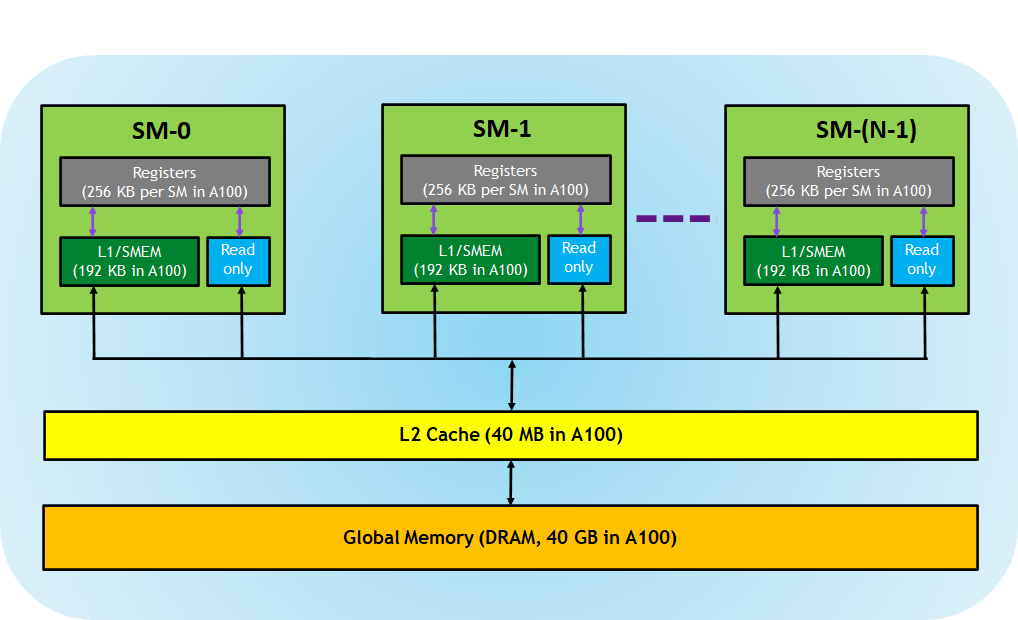
来源:NVIDIA 官方博客中的 A100 40GB 存储层次图。
命中缓存省掉的是去显存取数据,读取请求本身仍然要处理。 如果线程不断发出零散的请求,即使数据大多在缓存里,也可能让片上的访存单元忙不过来。这就能解释“L1/TEX 很忙”和“DRAM 很闲”为什么会同时出现。
接下来就回到代码:我们的线程究竟在怎样读 A、B,是否给访存单元制造了太多零散请求?
这里就要引入 warp:SM 中的调度器以 warp 为单位选择并发射指令,一个 warp 包含同一个 block 内连续 32 个线程,组内位置叫 lane。我们按单个线程写代码,执行时却是这一组线程一起处理各自的数据。
执行一条 global memory 读取指令时,硬件会收集参与这条指令的各 lane 的地址,再按地址合并请求。地址集中,就能用较少的内存事务完成;地址分散,就需要更多事务。因此,这里要看的是 同一条指令中这 32 个线程一起读哪里。
本例 block 是 (32,8),所以同一个 threadIdx.y 下的 32 个线程恰好组成一个 warp,负责 C 的同一行、相邻 32 列。固定 m 和当前的 k,这些线程读取的地址是:
lane       0             1             2          ...
读 A       A[m,k]        A[m,k]        A[m,k]     ...
读 B       B[n,k]        B[n+1,k]      B[n+2,k]   ...
B 的地址   n*K+k         (n+1)*K+k     (n+2)*K+k  ...
K=2048,一个 half 占 2 B,相邻 lane 的 B 地址就相差 4096 B。以 32 B 的 sector 为单位看,32 个相隔很远的 half 要触及 32 个 sector,实际只用到了其中 64 B 数据。如果这 32 个 half 相邻且对齐,就只需要覆盖两个 sector。这种把相邻线程的访问合并成少量请求的方式,就是 合并访存(coalescing)。
这也能解释为什么 DRAM 很闲。原始 B 的一行里,k=0 到 k=15 的 16 个 half 落在同一个 sector,后续读取可能命中缓存,不必每次都去显存取。但 warp 仍然在反复发出分散的请求。
找到这个问题后,修改就很直接了:让相邻 lane 读取的 B 元素也相邻。 我们先把 B 从 [N,K] 转置成 BT[K,N]:
BT[k*N+n] = B[n*K+k];
线程分工不变,每个线程仍然计算一个 C[m,n],只是 K 循环里改读 BT:
acc = fmaf(__half2float(A[m*K+k]),
           __half2float(BT[k*N+n]), acc);
同一个 warp 的访问于是变成:
lane       0           1           2           ...   31
读 BT      BT[k,n]     BT[k,n+1]   BT[k,n+2]   ...   BT[k,n+31]
地址       p           p+2B        p+4B        ...   p+62B
再跑一次:
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step0: naive | 407.47 ms | 0.291 TFLOP/s |
| step1 | 38.60 ms | 3.067 TFLOP/s |
只改布局,就快了约 10.6 倍。
我们这里忽略了修改布局所需要的时间,直到很后面才纠正,但也问题不大。
2. Register Tiling
step1 虽然修改了布局,但一个线程仍然只算一个输出。固定 k 看,同一个 A[m,k] 会被输出第 m 行的许多列使用,同一个 BT[k,n] 也会被输出第 n 列的许多行使用。缓存可以减少去显存取数的次数,但线程还是要执行 load、计算地址,再把 half 转成 float。我们能不能让已经读进寄存器的数多用一次,连这次重复的加载也省掉?
先看最容易想到的一处:同一列、相邻两行的输出。
\[C[m,n]=\sum_k A[m,k]BT[k,n],\qquad C[m+1,n]=\sum_k A[m+1,k]BT[k,n].\]两者使用不同的 A,却共享同一个 BT[k,n]。原来把这两个结果交给两个线程,各自读取一次 B;现在让一个线程同时算这两个结果,就能把 B 留在寄存器里直接复用。这就是这一步的 register tiling(寄存器分块)。
同一轮 k,计算同一列的两个输出:

原来两个线程分别计算:       现在一个线程计算:
A0 × B → C0                A0 × b → c0
A1 × B → C1                A1 × b → c1
                           ↑ 同一份寄存器里的 b

加载 2 份 A、2 份 B          加载 2 份 A、1 份 B
所以每轮变成:A 读两次,BT 读一次,用两个 accumulator 分别累加。
float c0 = 0, c1 = 0;  // 同一列的两个输出
for (int k = 0; k < K; ++k) {
    float b = __half2float(BT[k*N+n]);  // 两行共用这份 B
    c0 = fmaf(__half2float(A[m*K+k]),     b, c0);
    c1 = fmaf(__half2float(A[(m+1)*K+k]), b, c1);
}
按源码中的标量读取计算,完成这两个输出的一轮 k,加载和 half→float 转换都从四次变成三次,减少 25%,两次 FMA 则都保留。
放到 warp 的尺度看,原来计算两行、32 列输出,需要两个 warp;现在一个 warp 的每个 lane 各算两行,就能完成相同的工作。沿 N 方向的连续访问仍然保留:
处理两行、32 列输出的一轮 k:

原来:2 个 warp ×(A 的 1 个 sector + BT 的 2 个 sector)= 6 次 sector 访问
现在:A0 的 1 个 + A1 的 1 个 + BT 的 2 个               = 4 次 sector 访问
这里 A 在同一个 warp 内是同地址读取,BT 是连续的 32 个 half。按这个访问模型,sector 访问次数减少了约三分之一;这些次数描述请求工作量,实际有多少需要去 DRAM,仍取决于缓存。
线程分工也随之改变:block 仍是 (32,8),但一个线程负责两个输出,整个 block 就从覆盖 8×32 变成覆盖 16×32。我们没有增加线程,而是让每个线程用手里的数据多做一点计算。
代价是多保存一个累加器。不过现在只多一个 accumulator,负担不大。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step1:每线程一个输出 | 38.60 ms | 3.067 TFLOP/s |
| step2:每线程两个输出 | 27.65 ms | 4.281 TFLOP/s |
完整 GEMM 的计算量仍是 118.38 GFLOP,吞吐比前一步提高约 39.6%。这次靠的是让一次读入支撑更多计算。只是复用还局限在线程自己的寄存器里,不同线程之间仍然有重复加载。
3. 从单干到合作:shared memory
step2 已经让一个线程算两行、共用一份 B。但把视角拉到整个 block,重复读取仍然很多。这个 block 有 256 个线程,负责 16×32 的输出;我们先固定一个 k,看看这一轮究竟需要哪些数:
                       BT[k,n0]   BT[k,n1]   ...   BT[k,n31]
                           ↓         ↓                  ↓
A[m0,k]   →            C[m0,n0]   C[m0,n1]   ...   C[m0,n31]
A[m1,k]   →            C[m1,n0]   C[m1,n1]   ...   C[m1,n31]
  ...
A[m15,k]  →           C[m15,n0]  C[m15,n1]   ...  C[m15,n31]
A 的每个数沿着一行使用 32 次,BT 的每个数沿着一列使用 16 次。整个输出块这一轮只需要 16 个不同的 A 值和 32 个不同的 BT 值。
再看 step2 的程序:每个线程读取两个 A、一个 BT,256 个线程就是 768 次标量读取。BT 虽然已经在线程内部用了两次,但同一列还有另外七个线程,也在加载它。A 的同一个数则会被同一输出行的 32 个线程使用。
所以接下来想做的是:这 48 个输入,能不能由整个 block 合作搬一份,然后大家各取所需?
只靠前一步的寄存器不方便做到这件事。线程把 b 保存在自己的寄存器里,其他线程不能直接按地址读它。CUDA 为 block 内的这种合作提供了 shared memory:一块线程之间可以共同读写的片上存储。我们可以指定谁搬哪些数据、放到什么位置,再让其他线程从这里读取。step2 的 register tiling 保留,再在它外面加一层 block tiling。 每个线程仍然只维护自己的两个输出,不需要把整个 16×32 输出交给某一个线程。
不过,如果每个 k 都只搬这 48 个数,就要每算一步都让整个 block 等待、同步一次;A 这一列的全局地址也仍然相隔很远。更合适的办法是沿 K 一次准备一小段,让每行的输入连续起来,并用一轮搬运支撑多轮计算。
于是我们把 K 按 16 分块。每轮准备 A 的 16×16 和 BT 的 16×32,然后用它们更新当前的 C 块:
                     BT 的一个 K16 块:16×32
                     ┌──────────────────┐
                     │                  │
                     └──────────────────┘
                              ↓
A 的一个 K16 块:16×16       C 块:16×32
┌──────────────┐      ┌──────────────────┐
│              │  →   │ 累加本轮的贡献     │
└──────────────┘      └──────────────────┘

K 方向推进:
[0..15] → [16..31] → [32..47] → ...
   每轮换一块输入,始终累加到同一块 C
现在再算一次读取量。完成同一个输出块、同一段 K16,按每线程的标量读取统计:
| 从 global 读取的 half 数据 | step2:各线程分别读取 | step3:合作搬进 shared |
|---|---|---|
| A | 256 线程 × 2 个 × 16 轮 = 8192 | 16×16 = 256 |
| BT | 256 线程 × 1 个 × 16 轮 = 4096 | 16×32 = 512 |
| 合计 | 12288 | 768 |
还剩一个实际问题:768 个数怎么让 256 个线程搬?A 正好有 256 个元素,每个线程搬一个;BT 有 512 个,每个线程搬两个,核心代码如下。m_base、n_base 是这个 block 负责的输出块左上角:
// global ──每块合作搬一次──> shared ──各线程按需读取──> 寄存器
//                                                   │
//                                                FMA 累加
//
// 一个 block 的分工。格内数字是负责该元素的 tid,坐标相对于当前 tile。
//       搬运 sA[m][k]                  搬运 sBT[k][n] / 累加 C[m][n]
//          k=0    1  ...   15                n=0    1  ...   16  ...   31
// m=0        0    1  ...   15       k/m=0      0    1  ...   16  ...   31
// m=1       16   17  ...   31       k/m=1      0    1  ...   16  ...   31
// m=2       32   33  ...   47       k/m=2     32   33  ...   48  ...   63
// m=3       48   49  ...   63       k/m=3     32   33  ...   48  ...   63
// ...                               ...
// m=15     240  241  ...  255       k/m=15   224  225  ...  240  ...  255
//
// 例如 tid16 搬 sA[1][0]、sBT[0][16]、sBT[1][16],负责 C[0][16] 和 C[1][16]。
// kk=0 时,它算 c0 所读的 sA[0][0] 是 tid0 搬进来的。
__shared__ half sA[16][16];
__shared__ half sBT[16][32];

int tx = threadIdx.x, ty = threadIdx.y;
int tid = ty * 32 + tx;
int m_base = blockIdx.y * 16, n_base = blockIdx.x * 32;
float c0 = 0, c1 = 0;  // 累加器跨 K 块保留

for (int kb = 0; kb < K; kb += 16) {
    int ar = tid / 16, ak = tid % 16;
    sA[ar][ak] = A[(m_base + ar)*K + kb + ak];
    #pragma unroll
    for (int part = 0; part < 2; ++part) {
        int bk = 2*ty + part;
        sBT[bk][tx] = BT[(kb + bk)*N + n_base + tx];
    }
    __syncthreads();  // 所有人搬完,才能读别人的数据

    #pragma unroll
    for (int kk = 0; kk < 16; ++kk) {
        float b = __half2float(sBT[kk][tx]);
        c0 = fmaf(__half2float(sA[2*ty][kk]),   b, c0);
        c1 = fmaf(__half2float(sA[2*ty+1][kk]), b, c1);
    }
    __syncthreads();  // 所有人读完,才能覆盖旧数据
}

int m = m_base + 2*ty, n = n_base + tx;
C[m*N+n]     = __float2half_rn(c0);
C[(m+1)*N+n] = __float2half_rn(c1);
计算时,线程会读到同一个 block 里其他线程搬进 shared memory 的数据,因此需要用 __syncthreads() 同步。第一道屏障等大家写完再读,第二道等大家读完再覆盖。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step2:线程内复用 | 27.65 ms | 4.281 TFLOP/s |
| step3:block 内共享输入 | 16.05 ms | 7.377 TFLOP/s |
最终比 step2 提高约 72.3%。
4–6. 分块调参
step4 调线程分块,每个线程从算 2×1 改为算 2×2。固定一个 k,两个 A 和两个 BT 两两相乘,更新四个输出。每个 A 都能多用一次,耗时从 step3 的 16.05 ms 降到 12.93 ms,吞吐从 7.377 涨到 9.152 TFLOP/s。
step5 调 block 分块,每个 block 从算 16×32 扩到 32×32,每个线程还是算 2×2。原来算上、下两块输出要各搬一次 BT,现在更多输出行可以共用 shared 里的同一份 BT。这一步用了 11.42 ms,达到 10.369 TFLOP/s。
step6 两层一起调,每个 block 算 64×64,每个线程算 4×4。四个 A 和四个 BT 可以做 16 次 FMA。当时我们还顺手给 shared 里的 A 每行多留了两个 half,也就是 padding,让相邻行的起点落在不同的 bank 上。看一个 warp 的一次 shared 访问:多个线程访问同一 bank 的不同地址:需要拆成多次操作,即 bank conflict。多个线程读取完全相同的地址:通常使用 broadcast,不算普通冲突。两项合起来用了 8.48 ms,达到 13.967 TFLOP/s。
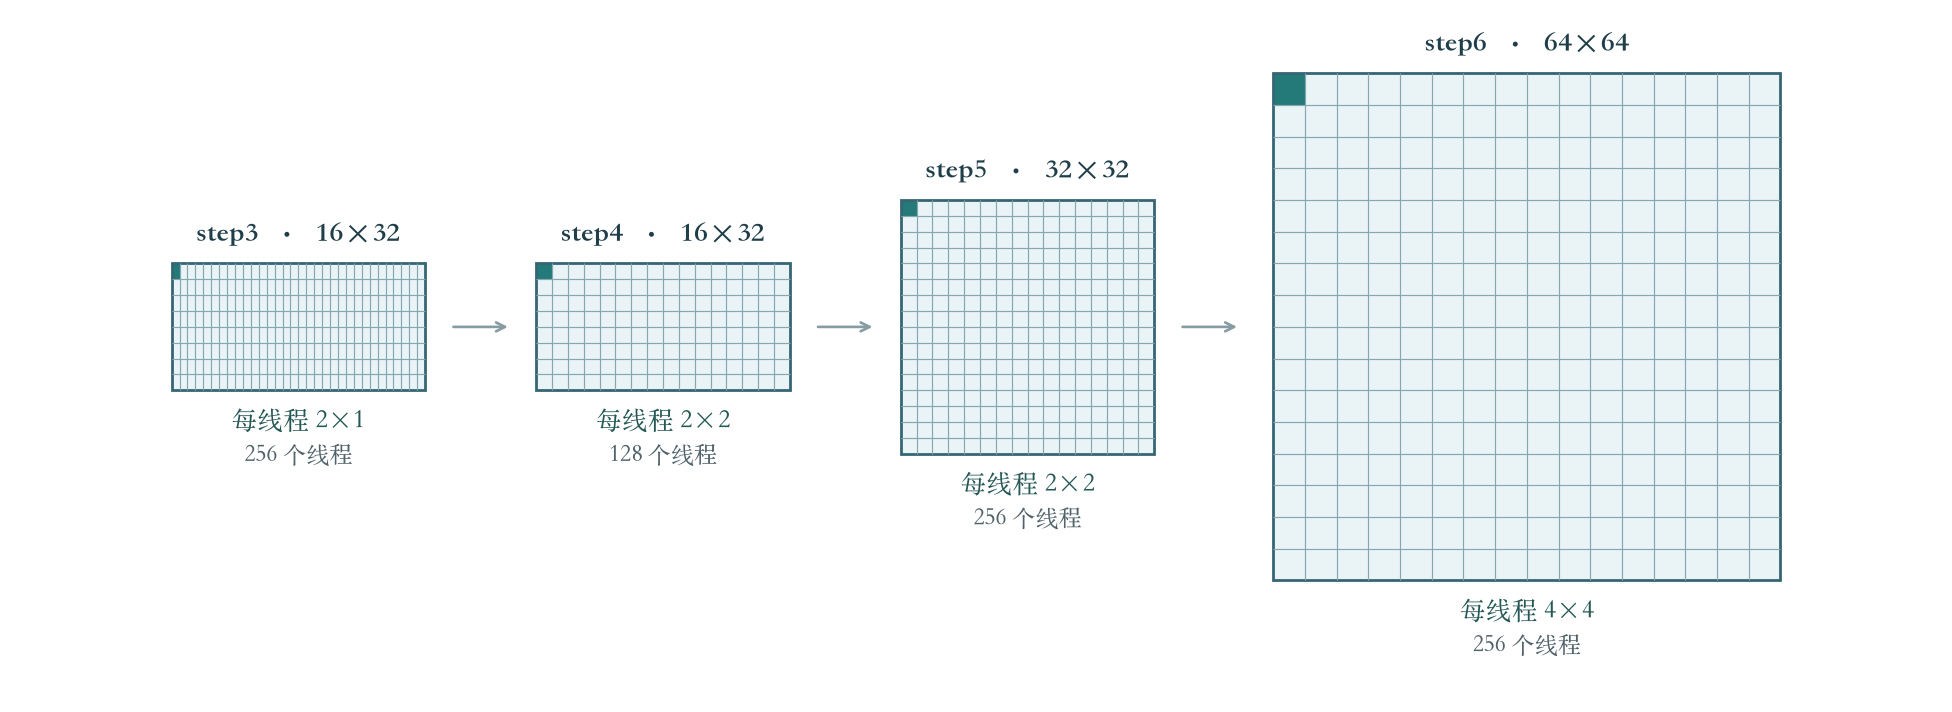
每个外框是一个 block 负责的 C 块,左上角的深色小格是其中一个线程负责的输出。
7. 进入 Tensor Core 时代
到 step6,我们很自然地会问:访存和复用已经改了这么多(其实也不多),为什么仍然只有十几个 TFLOP/s,cuBLAS 却有 243 TFLOP/s?难道后面还要靠更多的小优化追上去?
先算一下:如果一直使用普通 CUDA Core 上的 FP32 FMA,我们最多能优化到多块?
这张卡有 108 个 SM,每个 SM 有 64 个 FP32 CUDA Core。一个 FMA 做一次乘法加一次加法,按 2 FLOP 计算。按 1.41 GHz 的 SM 频率计算,峰值是:
\[P_{\mathrm{FP32}} =108\times64\times2\times1.41\times10^9 \approx19.5\ \mathrm{TFLOP/s}.\]108 个 SM
× 每 SM 每周期 64 个 FP32 FMA
× 每 FMA 2 FLOP
× 每秒 1.41×10⁹ 个周期
= 每秒约 19.5×10¹² 个浮点操作
这意味着,即使没有任何访存和同步损失,118.38 GFLOP 也至少要算约:
\[\frac{118.38\ \mathrm{GFLOP}}{19.5\ \mathrm{TFLOP/s}} \approx6.07\ \mathrm{ms}.\]而 cuBLAS 只需要约 0.487 ms,继续只优化这条普通 FP32 FMA 通路,不可能达到我们定下的目标。
这就引出了 A100 的每个 SM 里还有四个第三代 Tensor Core,一个专门用来做小矩阵的乘累加硬件。我们可以直接把两个 FP16 矩阵块交给这套硬件相乘,再把乘积累加到 FP32 的输出块里。
CUDA 提供了 WMMA 接口,让一个 warp 的 32 个线程协作完成一次矩阵乘累加。我们选 16×16×16,三个数依次表示输出行数 M、输出列数 N,以及这次沿 K 累加多少项:
具体到一个输出元素 D[i,j],它在原有的 C[i,j] 上加了 A 第 i 行与 B 第 j 列的 16 项点积。整个 warp 一次更新 256 个这样的元素,合计 256×16 = 4096 次 FMA,也就是 8192 FLOP。对我们 K=2048 的问题,同一块输出要累加 128 轮:第一轮算 K 的第 0~15 项,第二轮接着算第 16~31 项,一直累加到最后。
先看一个 K16 的最小计算片段:
using namespace nvcuda;
wmma::fragment<wmma::matrix_a, 16,16,16, half, wmma::row_major> a;
wmma::fragment<wmma::matrix_b, 16,16,16, half, wmma::row_major> b;
wmma::fragment<wmma::accumulator,16,16,16,float> c;

wmma::fill_fragment(c, 0.0f);      // 放在完整 K 循环外
wmma::load_matrix_sync(a, ptrA, strideA);
wmma::load_matrix_sync(b, ptrB, strideB);
wmma::mma_sync(c, a, b, c);  // C += A × B
fragment 可以理解为分散保存在各 lane 寄存器里的矩阵片段。WMMA 负责把矩阵元素分配到各个 lane 的寄存器里。
step7 沿用 64×64 CTA,但把“每线程算 4×4”改成“每 warp 算 32×16”。八个 warp 如下分工:
                     N 方向
              0–15    16–31   32–47   48–63
M   0–31     warp0    warp1   warp2   warp3
   32–63     warp4    warp5   warp6   warp7

一个 warp 的 32×16:
       A 上半 16×16 ─┐       C 上半 16×16
                     ├─ B ─→
       A 下半 16×16 ─┘       C 下半 16×16
每轮 K16,一个 warp 加载两份 A fragment,共用一份 B fragment,调用两次 WMMA。shared 仍由整个 CTA 合作填充;我们只是把计算所有权和计算指令换成了 warp 级别。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
step6:每线程算 4×4,标量 FMA | 8.476 ms | 13.967 TFLOP/s |
step7:每个 warp 算 32×16,使用 WMMA | 2.994 ms | 39.539 TFLOP/s |
| cuBLAS | 0.487 ms | 243.175 TFLOP/s |
换用 Tensor Core 后,吞吐一下子提高到 step6 的 2.83 倍,跨过了普通 FP32 FMA 的上限,硬件才是正道!
8–9. 给 Tensor Core 搬数据
step7 换上了 Tensor Core,吞吐涨到 39.5 TFLOP/s,但离 cuBLAS 还差一大截。 ncu 报告里,Tensor 管线的活跃比例只有约 13%,DRAM 吞吐也只有峰值的 7.33%。显存带宽还有余量,Tensor Core 又经常空着,我们就去看 warp 在等什么。最大的等待项是 Long Scoreboard,平均每个 warp 两次发射之间的 13.78 个周期里,有约 6.52 个周期在等待 L1/TEX 访存依赖。回到 step7 的 K 循环,每个线程先从 global 读一个 half,数据返回寄存器,才能把它写进 shared。整个 block 搬完当前 tile,warp 才能加载 fragment、开始 WMMA。于是我们先检查这段输入搬运。
step8 重新分工,让每个线程负责同一行中连续的八个 half。可以用一个 uint4 把这八个 half 一起读进寄存器,再一起写进 shared。这样仍然搬 4096 B,按源码估算,每个 CTA 每轮的 global load 从 64 条降到 8 条,对应的输入 shared store 也从 64 条降到 8 条。
对于当时的 K16 stage,A 是 64×16,BT 是 16×64。两边各有 128 个 16B 向量,256 个线程刚好分成两半:
线程   0–127:搬 A,每行 16 half = 2 个向量
线程 128–255:搬 BT,每行 64 half = 8 个向量

A 的第 0 行:线程 0 搬 [0..7],线程 1 搬 [8..15]
A 的第 1 行:线程 2 搬 [0..7],线程 3 搬 [8..15]
这让我们的吞吐来到了55.213 TFLOP/s。
另一方面,Ampere 提供了 cp.async,可以直接把 global 数据异步复制到 shared,避免用普通中间寄存器承接这份拷贝。step9 把这条指令用在每线程 16B 的搬运上。NVIDIA 对 Ampere 异步搬运的说明
unsigned dst = static_cast<unsigned>(__cvta_generic_to_shared(shared_ptr));
asm volatile("cp.async.ca.shared.global [%0], [%1], 16;"
             :: "r"(dst), "l"(global_ptr) : "memory");
16 是每线程复制的字节数,一个完整 warp 合计搬 512 B。
发出本线程的复制;
cp_async_commit_group();  // 提交本线程的复制组
cp_async_wait_group0();  // 等待本线程复制完成
__syncthreads();
读取 shared,执行 WMMA;
commit_group 把本线程此前未提交的复制归成一组;wait_group 0 等待本线程所有已提交组完成。由于后面还会读取其他线程搬来的数据,再用 CTA barrier 把大家的完成状态连接起来。
单是把同步搬运加宽,step8 的吞吐就提高了约 39.6%。step9 再换成异步复制,又提高了约 7.5%。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step7:WMMA,标量搬运 | 2.994 ms | 39.539 TFLOP/s |
| step8:16B 向量搬运 | 2.144 ms | 55.213 TFLOP/s |
| step9:单缓冲 cp.async | 1.995 ms | 59.340 TFLOP/s |
10–11. 流水线
回看 step9,cp.async 发出去以后,我们紧接着就调用了 wait_group 0。于是每轮还是先等输入到齐,再做 WMMA。
但算 tile0 的时候,tile1 的地址已经知道了。两轮计算要依次更新同一份累加器,搬 tile1 却用不着等 tile0 算完。如果把这次复制提前发出去,就能用当前这轮 WMMA 的时间,覆盖一部分等下一块输入的时间。
时间向右 →
计算:            [ 算 tile0 ] [ 算 tile1 ] [ 算 tile2 ]
搬运:[搬 tile0]  [ 搬 tile1 ] [ 搬 tile2 ] [ 搬 tile3 ]
槽位:    0            1            0            1
先搬好 tile0。每轮发起下一块的复制,然后计算当前块,最后才等下一块,并同步切换。
prefetch(tile0, buffer0);
commit(); wait_all(); __syncthreads();

for (int t = 0; t < tiles; ++t) {
    if (存在下一块) {
        prefetch(t+1, 另一个buffer);
        commit();
    }
    compute(当前buffer);
    if (存在下一块) wait_all();
    __syncthreads();
    切换buffer;
}
这个 barrier 同时完成两件事:下一块的生产者都已搬完;当前块的消费者都已读完。下轮才能安全地读新槽、覆盖旧槽。
从单缓冲改成双缓冲,吞吐提高了约 15.5%。两版搬的是同样多的 A 和 BT,双缓冲把下一块输入的等待挪进了当前块的计算时间里,轮末的 barrier 也同时负责发布新块和释放旧槽。
最初我们顺势试了三缓冲,把预取再提前一块,耗时却和双缓冲几乎一样。多给搬运一些时间,为什么没什么用?当时这两版都用 cp.async.ca,于是我们把它们的 ncu 报告放在一起看。
.ca 下的 profiling | 双缓冲 | 三缓冲 |
|---|---|---|
| L1/TEX 吞吐(相对峰值) | 85.66% | 87.24% |
| DRAM 吞吐(相对峰值) | 8.18% | 8.12% |
| global load 的 L1 命中率(按 sector 计) | 0.45% | 0.09% |
L1/TEX 这条路径很忙,但 global load 在 L1 的命中率连 1% 都不到。回头看代码倒是好理解:一个 CTA 把当前的 A、BT 搬进 shared 以后,各个 warp 就从 shared 里取 fragment。等到下一轮 cp.async,它要读的已经是下一段 K 了。既然 CTA 内的复用发生在 shared,给源数据在 L1 里也留一份,能赚到多少?
于是我们先固定双缓冲,只把 cp.async.ca.shared.global 改成 cp.async.cg.shared.global。两种写法都把数据搬进 shared,区别在于怎样缓存 global 端读到的数据。.ca 允许在 L1 和 L2 缓存,.cg 让这次读取绕过 L1 数据缓存,仍可在 L2 命中。这个改动让双缓冲从 68.519 提高到 76.177 TFLOP/s,约快 11.2%。
有了这个对照,再来比较同样使用 .cg 的双缓冲和三缓冲。step11 的第三个槽让我们在计算 tile0 时就发起 tile2 的复制:
当前计算       更远预取                  下一轮开始前
 tile0         tile2 → buffer2          确保 tile1 完成
 tile1         tile3 → buffer0          确保 tile2 完成
 tile2         tile4 → buffer1          确保 tile3 完成
“提前两块”也不等于“一次计算要新搬两块”。启动时先准备 tile0、tile1,稳态每轮仍只新增一个 tile(t+2),只是让它比使用时间更早进入流水线。
此时可以使用 wait_group 1:允许最新的一组继续在途,要求更旧的组完成。到了尾部,没有更远的 tile 可以预取,就逐步用 wait_group 0 排空。
固定 .cg 后,从两个槽增加到三个槽,吞吐从 76.177 提高到 82.223 TFLOP/s,又快了约 7.9%。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
step9:单缓冲,.ca | 1.995 ms | 59.340 TFLOP/s |
step10:双缓冲,.ca | 1.728 ms | 68.519 TFLOP/s |
双缓冲,.cg(三缓冲的对照) | 1.554 ms | 76.177 TFLOP/s |
step11:三缓冲,.cg | 1.440 ms | 82.223 TFLOP/s |
12. 故伎重施
step12 把一个 stage 从 K16 扩为 K32。A 现在有 64×32 个 half,BT 有 32×64 个 half,各需要 256 个 16B 向量。每个线程分别搬一份 A 和一份 BT:
// tid 同时作为 A、BT 的向量编号
int a_row = tid / 4;  // A 每行四个向量
int a_col = (tid % 4) * 8;  // 起始 half 列号
int b_row = tid / 8;  // BT 每行八个向量
int b_col = (tid % 8) * 8;  // 起始 half 列号
A 的一行有 32 个 half:
列位置       0..7       8..15      16..23     24..31
第 0 行      tid0       tid1       tid2       tid3
第 1 行      tid4       tid5       tid6       tid7
第 2 行      tid8       tid9       tid10      tid11
...
第 7 行      tid28      tid29      tid30      tid31
tid / 4 算第几行,tid % 4 算行内第几个向量,还要乘 8 才是 half 列号。比如 tid=13:行号是 3,行内向量号是 1,所以搬第 3 行的 half[8..15]。
现在一个 warp 的 A 复制覆盖八行,每行 64 B;原来 K16 时覆盖十六行,每行 32 B。同样是这个 warp 的 512 B 数据,分散到的行更少了。在行起点对齐的当前 shape 下,对应的不同 cache line 也更少。与此同时,K 循环的 stage 数从 128 减到 64,每个 stage 里做两次 K16 WMMA。提交、等待、CTA 同步和循环管理也随之减少。
K16 三缓冲约 82.2 TFLOP/s,K32 约 100.9 TFLOP/s,提高了约 22.7%。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step11:K16 | 1.440 ms | 82.223 TFLOP/s |
| step12:K32 | 1.174 ms | 100.877 TFLOP/s |
13–16. 故伎重施
step12 用上 K32 以后,光是三份输入 buffer,每个 CTA 就要用掉 29,184 B 的 shared。代码里还给输出留了一块 float output[64][64]。想想这个数组什么时候才用得上?沿 K 累加的时候,结果一直在 warp 的寄存器里。直到最后一次 WMMA 做完,我们才把结果写进 shared,再转成 half 写回 C。这时候三份输入都已经用完了。
所以 step13 让它们共用同一段地址。等最后一批异步复制完成、所有 warp 都读完输入,再把这段 shared 当作输出用。
union SharedStorage {
    InputStages input;
    float output[BM][BN];
};
这样每个 CTA 恰好省下一个输出块,也就是 16 KiB。主循环每轮搬的数、做的乘加都和原来一样,吞吐从 100.9 涨到 104.7 TFLOP/s。省下这块空间,倒让我们有余地再试一次前面管用的办法:把 block 做大,让更多输出共用一份输入。
step14 先固定一块 128×128 的输出。 如果交给四个 64×64 的 CTA,固定一轮 K32,它们各自要搬哪些数据?
                     左 64 列         右 64 列
上 64 行           A上 × BT左       A上 × BT右
下 64 行           A下 × BT左       A下 × BT右
看上面一行,左右两个 CTA 各搬了一次 A上。再看左边一列,上下两个 CTA 又各搬了一次 BT左。四个 CTA 合计要往 shared 搬 32 KiB 输入。先把上下两块并成一个 128×64,同一份 BT 就只搬一次,合计降到 24 KiB。再把左右也并起来,一个 128×128 CTA 总共只要搬 16 KiB。
结果前一次从 104.7 涨到 106.9 TFLOP/s,后一次却掉到 92.8 TFLOP/s。哪里想漏了?我们扩大了 CTA,却一直让每个 warp 只算 32×16。
step15 保留这个掉速的 128×128,看看相邻两个 warp 在读什么。 固定一轮 K16,拿同样的 32×32 输出来比,每个小格都是一次 16×16 WMMA:
                左 16 列      右 16 列
上 16 行        A0 × B0       A0 × B1
下 16 行        A1 × B0       A1 × B1

原来分给两个 warp     左边读 A0、A1、B0,右边又读 A0、A1、B1
现在交给一个 warp     A0、A1、B0、B1 各读一份,还是做四次 WMMA
这和 step2 让一个线程算两个输出是同一个想法,只是当时复用一个数,这次复用一整个 fragment。算完同一个 CTA,每轮 K16 的 fragment 加载从 96 次减到 64 次,WMMA 都是 64 次。现在 16 个 warp 就够了,吞吐也从 92.8 回到 112.6 TFLOP/s。
到了 step16,问题又换了一层。ncu 显示一个 SM 只能驻留一个这样的 CTA。一个 CTA 有 512 个线程,编译器给每个线程分了 72 个寄存器。要让两个 CTA 一起驻留,光寄存器就需要 72 × 512 × 2 = 73,728 个,超过 SM80 每个 SM 的 65,536 个。倒过来算,每线程刚好要压到 64 个,第二个 CTA 才放得下。 shared 也要算进去,每个 CTA 要 64 KiB,而这次 profile 里一个 SM 只划了 100 KiB 给 shared。SM80 的资源配置
于是我们用 __launch_bounds__(512, 2) 让编译器按两个 CTA 的目标分配寄存器,同时请求把更多片上空间划给 shared。再看 ncu,每线程用了 64 个寄存器,每个 SM 给 shared 划了 164 KiB,两边都够了。第二个 CTA 有什么用,这次也能直接从 profile 里看到:每个 warp 调度器平均每周期有资格发射指令的 warp 从 0.59 增到 1.16。一个 warp 等数据时,调度器更有机会从另一个 CTA 挑到活干。吞吐到了 135.2 TFLOP/s。
那编译器为什么一开始就不给 64 个?看这次编译结果就能理解它的取舍。用 72 个时,线程的临时值都放得下;压到 64 个后,已经有少量值要写到 local memory 再读回来,也就是 spill。这笔额外读写值不值,取决于第二个 CTA 跑起来能帮我们填上多少等待时间。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
step12:CTA 64×64 | 1.174 ms | 100.877 TFLOP/s |
| step13:复用 shared 空间 | 1.130 ms | 104.715 TFLOP/s |
step14:CTA 128×64 | 1.108 ms | 106.884 TFLOP/s |
step14:CTA 128×128 | 1.276 ms | 92.796 TFLOP/s |
step15:warp 32×32 | 1.051 ms | 112.632 TFLOP/s |
| step16:为两个 CTA 留出寄存器 | 0.876 ms | 135.179 TFLOP/s |
17–18. warp 调参
step16 用另一个 CTA 的 warp 来填等待时间。我们自然也想试试,同一个 warp 能不能一边算,一边准备下一份输入?前面用 cp.async 提前把数据从 global 搬到了 shared。沿着数据再往里走一步,这次想提前的是 shared → 寄存器。
step17 还是看刚才那四个小格。先算左边的 A0 × B0 和 A1 × B0,这轮的 B0 就用完了。右边两格只用 B1,于是可以把下一轮 K16 的 B0 提前加载到原来的位置,再接着算右边。这样既给加载留了一点时间,也不用再备一整套 fragment。
实测 step16 是 135.2 TFLOP/s,提前加载后是 133.7 TFLOP/s。没啥影响。
step18 回到 step16。 step15 把左右两块输出交给同一个 warp,省下了重复读 A。那上下两块呢?它们用的正是同一份 B。把 warp 从 32×32 加高到 64×32,一个 CTA 就这样分:
                  N 方向
             0–31   32–63   64–95   96–127
M   0–63     warp0  warp1   warp2   warp3
   64–127    warp4  warp5   warp6   warp7
拿 warp0 来看。原先上下两个 warp 各读两份 A、两份 B,一共八份 fragment。合并后四份 A 都得读,但两份 B 各读一次就够了,一共六份。算完整个 CTA,每轮 K16 又从 64 次 fragment 加载降到 48 次。吞吐从 135.2 涨到 154.4 TFLOP/s。
照这个思路再宽一倍呢?64×64 确实还能少读,每轮整个 CTA 只用加载 32 份 fragment。代价也很直观,一个 warp 要一直攒着 64×64 个 FP32 输出,摊到每个线程,光累加结果就有 128 个。编译结果从每线程 126 个寄存器涨到 241 个,一个 CTA 里可供调度的 warp 又从 8 个减到了 4 个。实测掉回 147.5 TFLOP/s,所以我们选了 64×32。
最后还可以沿 K 多看一块。算 tile 0 时,三缓冲最多能提前搬到 tile 2,加一个 shared 槽就能搬到 tile 3。这里正好又用到了 step13 的 union:原来三份输入合计 55.5 KiB,比写回用的 64 KiB 还小。加到四份输入是 74 KiB,所以整个 CTA 的 shared 占用只从 64 涨到 74 KiB,两个 CTA 仍然放得下。多预取一块之后,吞吐从 154.4 涨到 160.2 TFLOP/s。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
step16:warp 32×32 | 0.876 ms | 135.179 TFLOP/s |
| step17:预取寄存器 fragment | 0.886 ms | 133.679 TFLOP/s |
step18:warp 64×32,三缓冲 | 0.767 ms | 154.388 TFLOP/s |
step18:warp 64×64,三缓冲 | 0.803 ms | 147.494 TFLOP/s |
step18:warp 64×32,四缓冲 | 0.739 ms | 160.163 TFLOP/s |
19. 去掉转置
到这里,我们一直盯着 GEMM 本身的时间,原先准备 BT 的转置留在前面。后来突然想起来:如果实际应用每次都给原始 B,那这一步也要花时间。更关键的是,现在已经用 WMMA 了,为什么还必须先转置?
还真不用。step1 为了标量线程合并访存准备了 BT,后面换成 WMMA,我们却一路把这项准备工作保留了下来。
先用一个 B[3,4] 看 row-major 和 col-major:
B 的数学形状:3×4,按行存储
       k0   k1   k2   k3
n0     a    b    c    d
n1     e    f    g    h
n2     i    j    k    l

内存:a b c d | e f g h | i j k l

Bᵀ 的数学形状:4×3,按列解释同一份内存
       n0   n1   n2
k0     a    e    i
k1     b    f    j
k2     c    g    k
k3     d    h    l

每一列仍是:a b c d | e f g h | i j k l
原始 B 的 row-major 地址是 n*K+k。把同一块内存解释成 Bᵀ[K,N] 的 col-major,地址也是 k+n*K。
step19 直接沿原始 B 的 K 方向做连续向量搬运,shared 中也按 [n][k] 保存。然后告诉 WMMA,它的右操作数按列存储:
wmma::fragment<wmma::matrix_b,16,16,16,half,wmma::col_major> b;
wmma::load_matrix_sync(b, &sB[local_n][local_k], LD_B);
这里 LD_B 是 shared 中相邻 n 行的物理间距,也就是逻辑右操作数相邻列的间距。WMMA 的布局参数帮我们完成了所需解释。
把转置也算进去,对照是:
| 路径 | 时间 | 吞吐 |
|---|---|---|
| step18 四缓冲,加上准备 BT | 1.048 ms | 112.9 TFLOP/s |
| step19 直接读取 B | 0.729 ms | 162.3 TFLOP/s |
| cuBLAS | 0.487 ms | 243.2 TFLOP/s |
20. 去掉边界判断
到了这里,又有点不知道下一步往哪走了。分析 step19 的 profile,每个 scheduler 平均有约 3.89 个 active warp,但只有约 0.66 个 eligible warp,issue-active 约 41%。active 表示已经驻留,eligible 表示当前有指令可以发射。每个 scheduler 平均驻留着近四个 warp,实际可发指令的却不到一个。
step20 先去掉完整 tile 搬运里的边界分支。诊断时看到指令确实减少了:动态 warp 指令从 1.740 亿降到 1.439 亿,但吞吐从 step19 的 162.276 降到 157.759 TFLOP/s,没有提速,暂时继续用 step19。
| 实现 | 耗时 | 吞吐(TFLOP/s) |
|---|---|---|
| step19:直接读取 B | 0.729 ms | 162.276 |
| step20:完整 tile 搬运 | 0.750 ms | 157.759 |
21. 从 WMMA 到手写 PTX
回到 step19,我们用的是 WMMA + padding。shared 里每行放 32 个 half,行尾再空出 8 个。给 wmma::load_matrix_sync 一个起点和 40 个 half 的行跨度,后面每一行去哪里读就都确定了。乘法也交给 wmma::mma_sync,我们只管把 A、B 的 fragment 传进去。
为了进一步加速,我们决定放弃 cuda 给我们提供的强大的 wmma API (听说他的性能也一直为人诟病),自己实现 shared memory 到 register 的数据搬运以及 mma 指令的调用。
我们想试试能不能把行尾那 8 个 half 省下来。padding 原本是为了把各行的起点错开,免得几个线程同时读到同一组 bank。现在要把行排紧,就得先看看 Tensor Core 算一块 A 之前,warp 到底要从 shared 读哪些数。
这次我们自己写加载函数 load16x16_swizzled,替换 wmma::load_matrix_sync。它里面用到的 ldmatrix 是一条 warp 级指令。八个 lane 各给出一行的起始地址,硬件从每行取连续八个 half,再把这 64 个数分到整个 warp 的寄存器里。我们可以分别指定这八行从哪里开始读。 有了这个自由度,行尾的 padding 就有了另一种做法。
Swizzle:把每行的四组数据错开放
拿 A 左上角的 8×8 来看。写入时,cp.async 一次搬连续八个 half,正好是这个小矩阵的一行。我们可以把这 16B 原样放进 shared,只换它在行内的位置。读取时,只要给 ldmatrix 换过位置的行地址,它就能把同一个小矩阵读回来。
CUTLASS 这张图画的就是这个想法。上图的蓝框标出一次加载要读的数据,下图标出它们在 shared 里的位置。两张图里找同一个 T2,读的还是那段数据。再把 T0 到 T7 一起看,它们在下图恰好各占一列。每列对应四个连续的 4B bank,这八段 16B 就可以分摊到全部 32 个 bank 上。NVIDIA CUTLASS 原图与说明
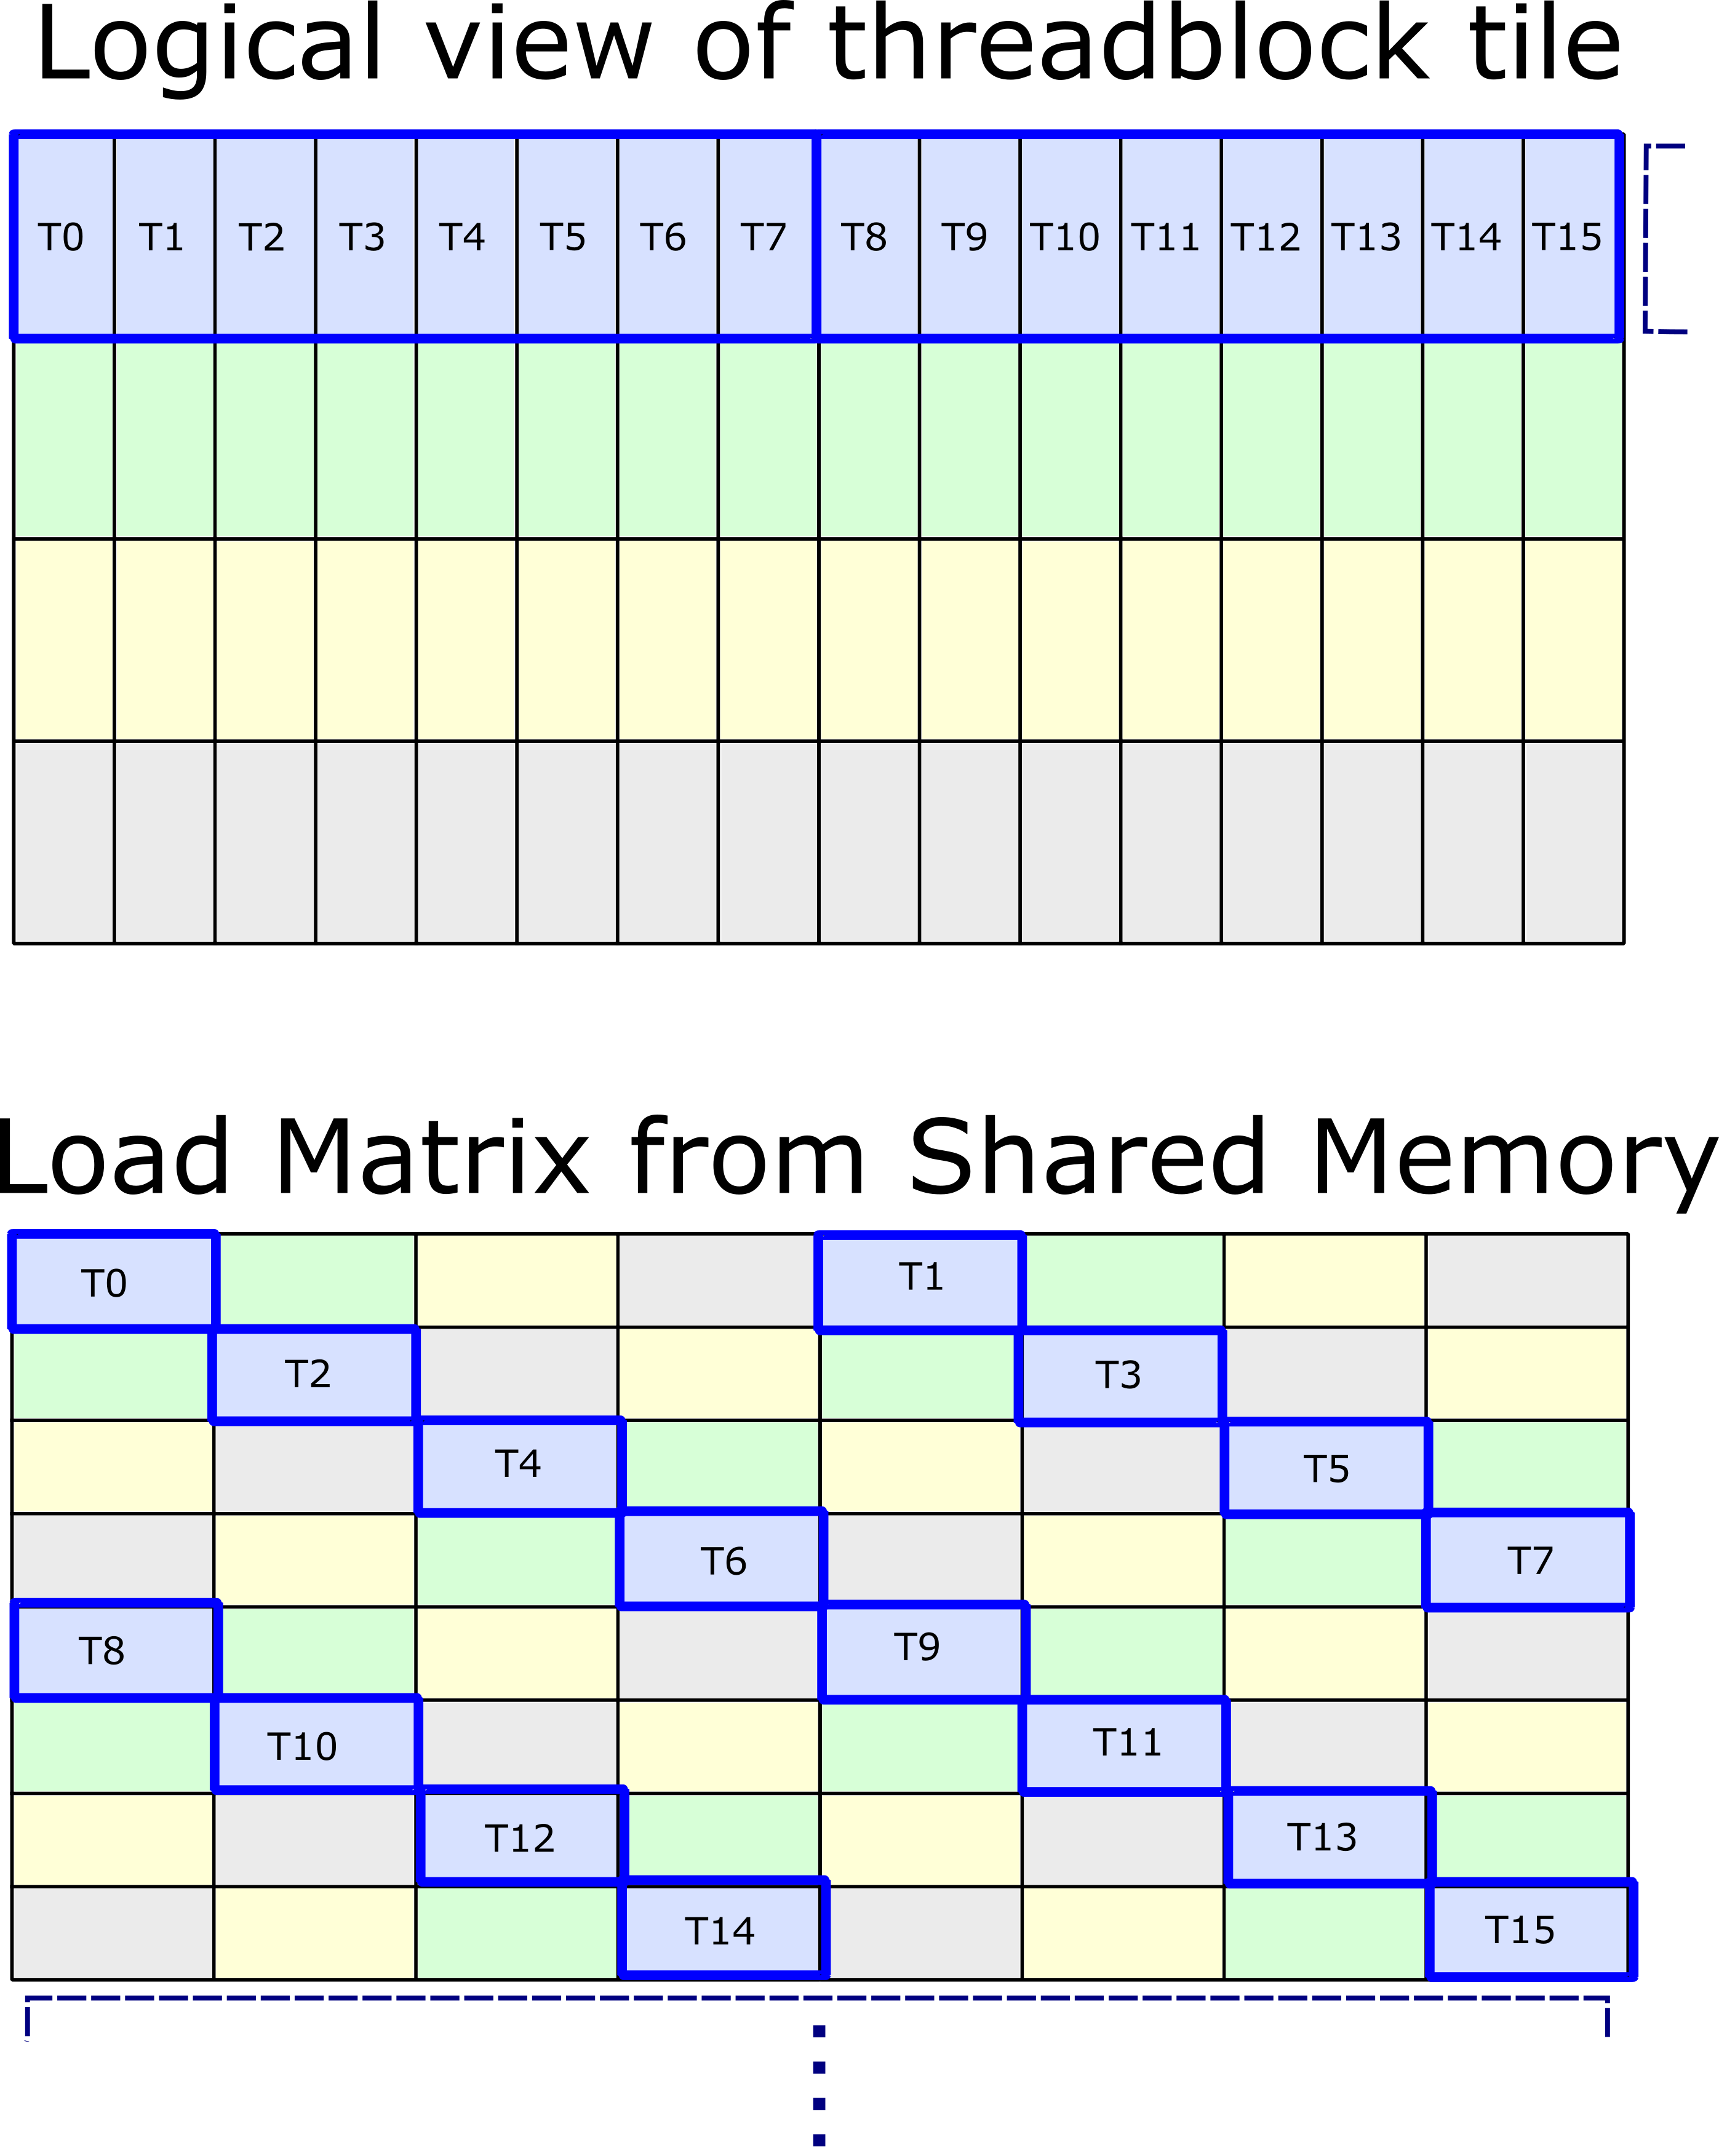
我们的 K32 每行有四个这样的 16B 组。假如每一行都把第零组放在行首,一行 64B,跨过 16 个 bank,第 0 行从 bank 0 开始,第 1 行从 bank 16 开始,第 2 行又绕回 bank 0。于是前两行可以照旧放,第 2、3 行把第零组放到位置 1,第 4、5 行放到位置 2,第 6、7 行放到位置 3。读左上角这八行时,起始 bank 就错开了:
行号                  0   1   2   3   4   5   6   7
第零组都放在行首       0  16   0  16   0  16   0  16
第零组按行换位置       0  16   4  20   8  24  12  28
其余三组也得各有位置。这就用到了 XOR:用逻辑组号与同一个 mask 异或,恰好会把 0、1、2、3 重新排一遍。比如第 2 行的 mask 是 1,四组就分别放在 1、0、3、2。每两行换一次 mask,写成代码就是 (row % 8) / 2。
int swizzle_col(int row, int col) {
    int group  = col / 8;  // 16B 组号
    int within = col % 8;  // 组内位置
    int mask   = (row % 8) / 2;
    return (group ^ mask) * 8 + within;  // 换组,组内顺序不变
}
比如第 2 行的第 0 个 half,swizzle_col(2, 0) 返回 8。写入时,cp.async 把这一组搬到偏移 2×32 + 8 = 72 的地方;读这个小矩阵时,lane 2 给出的也是偏移 72。组内的八个 half 始终连在一起。
用 ldmatrix 读回一个 fragment
刚才是左上角的 8×8。一份 A fragment 有 16×16,正好可以切成四个这样的小块。我们用 ldmatrix.x4 一次取齐,32 个 lane 分四组,每组给出一个小块的八行地址:
                 k 0..7             k 8..15
行 0..7       P(lane 0–7)      Q(lane 16–23)
行 8..15      R(lane 8–15)     S(lane 24–31)
顺着 lane 编号读,顺序是 P、R、Q、S。前 16 个 lane 读左半边的 16 行,后 16 个读右半边的同样 16 行。因此 lane % 16 就是相对行号,(lane / 16) * 8 选左半边或右半边。算出逻辑坐标,再用刚才写入时的 swizzle_col 找到实际地址:
int row = tile_row + lane % 16;  // 本 lane 提供的行
int col = tile_k   + (lane / 16) * 8;  // 左、右两个 K8 区域
const half* p = stage + row * 32 + swizzle_col(row, col);  // 逻辑坐标 → shared 地址

unsigned shared_address = static_cast<unsigned>(__cvta_generic_to_shared(p));
asm volatile("ldmatrix.sync.aligned.m8n8.x4.shared.b16 "
             "{%0,%1,%2,%3}, [%4];"
             : "=r"(frag[0]), "=r"(frag[1]),
               "=r"(frag[2]), "=r"(frag[3])
             : "r"(shared_address) : "memory");
看这条汇编的两端就能接上乘法了。右边的 shared_address 是每个 lane 提供的一个行地址,左边的 frag[0..3] 是每个 lane 收到的四个寄存器,分别装着来自 P、R、Q、S 的两个 half。整个 warp 收到 32 × 4 × 2 = 256 个 half,刚好一整块 A。PTX 对 ldmatrix 的定义
原来下一行直接调 wmma::mma_sync,现在由我们把寄存器交给 mma_m16n8k16。里面是一条 Tensor Core 的 mma.sync 指令,一次算 C 的 16 行、8 列。为了算完原来的 16 列,我们调用两次,两次共用 A 的四个寄存器,每次从 B 取两个。
每个 CTA 的 shared 也从 80 KiB 降到 64 KiB,但这版手写加载和乘加跑得比 step19 慢了约 0.073 ms。这也说明 wmma 不是那么好战胜的,需要仔细分析。
| 实现 | 耗时 | 吞吐(TFLOP/s) |
|---|---|---|
| step19:WMMA + padding | 0.729 ms | 162.276 |
| step21:手写 MMA + swizzle | 0.802 ms | 147.569 |
22. 顺流而下
先只算 C 的前 8 列。一条 m16n8k16 沿 K 做 16 项乘加,B 又是按 B[n][k] 存的,所以这条 MMA 要读 B 的前 8 行、全部 16 个 k。下一条 MMA 算 C 的后 8 列,共用同一块 A,换成 B 的后 8 行。把这次加载的 B 画出来,每个字母代表一个 8×8 小块:
                 k 0..7     k 8..15
B 的 n 0..7         P          Q      ← 第一条 MMA 一起用 P、Q
B 的 n 8..15        R          S      ← 第二条 MMA 一起用 R、S
现在只盯住一个 lane。一次 ldmatrix.x4 之后,它手里有四个寄存器。下面写 P,指的就是这个 lane 从 P 分到的两个 half。step21 给 B 用了和 A 相同的加载函数,顺序是先读图的左半边,再读右半边:
寄存器位置         b[0]   b[1]   b[2]   b[3]
step21              P      R      Q      S
                    ↑             ↑
第一条 MMA          └─────要这两个──┘
那直接把 b[0] 和 b[2] 传进去行不行?行,step21 就是这么写的,结果也算对了。多出来的工作,要看 GPU 最终执行的机器指令。A800 的 HMMA.16816 给 B 只写一个起始寄存器号。写 R84,硬件就取 R84 和 R85。但这里 P 落在 R20,Q 落在 R22,中间隔了一个。看 step21 的 SASS,加载和乘法之间果然夹着两条复制:
LDSM.16.M88.4 R20, [R20+0x8000]    // R20=P,R21=R,R22=Q,R23=S
IMAD.MOV.U32 R84, RZ, RZ, R20      // 把 P 复制到 R84
IMAD.MOV.U32 R85, RZ, RZ, R22      // 把 Q 复制到紧邻的 R85
HMMA.16816.F32 R76, R12, R84, R76  // B 写 R84,实际读 R84、R85
既然乘法要 P、Q 挨在一起,我们能不能在加载时就把 P、Q 排在一起?四组 lane 的行地址本来就是我们给的。把中间两组提供的地址对调,四块 B 还是一条 ldmatrix.x4 读进来,返回的顺序就正好了:
寄存器位置         b[0]   b[1]   b[2]   b[3]
step22              P      Q      R      S
                    └──┬───┘      └──┬───┘
                    第一条 MMA    第二条 MMA
代码里有两处要配合着改。先改 B 的读地址。step22 给 B 单独写了 load16x16_bpaired_swizzled,其中算行、列的两行变成:
// step21:B 和 A 共用 load16x16_swizzled
int row = tile_row + lane % 16;
int col = tile_k   + (lane / 16) * 8;

// step22:B 改用 load16x16_bpaired_swizzled
int row = tile_row + (lane / 16) * 8 + lane % 8;  // 先取同一组 n 的两半 K
int col = tile_k   + ((lane / 8) % 2) * 8;
代入 lane 8 就能看出改在哪:它原来提供块内 (n=8, k=0) 的地址,指向 R,现在提供 (n=0, k=8) 的地址,指向 Q。lane 16 恰好从 Q 换到 R。两组都用原来的 swizzle_col 去找各自在 shared 里的位置。
再改 MMA 取 B 的下标。把这次加载得到的 b_frag[j/2] 简写成 b。两条 MMA 原来分别取 (0,2)、(1,3),现在改取 (0,1)、(2,3),送进去的仍然是前八列用的 P、Q 和后八列用的 R、S。
// step21
mma_m16n8k16(c_frag[i][j], a_frag[i], b[j % 2], b[j % 2 + 2]);

// step22
mma_m16n8k16(c_frag[i][j], a_frag[i], b[2 * (j % 2)], b[2 * (j % 2) + 1]);
再看 step22 的 SASS,这次加载把 B 写进 R8 到 R11,两条 HMMA 的 B 操作数直接写 R8、R10,就能各取一对。
上面摘出的两条 IMAD.MOV.U32 都在 K 主循环里。这个 shape 有 42×42 个 CTA,每个 CTA 有 8 个 warp,每个 warp 要走 2048/32 = 64 轮 K32。光是图里 R20 → R84 这一行,一次 GEMM 就执行了 903,168 次,和 ncu 的逐指令计数一致。再把循环里各处为 B 凑对的搬移加起来,就能看懂下面这个差距了。
| 实现 | 每次 GEMM 的 IMAD.MOV.U32 | 总动态 warp 指令 | 耗时 | 吞吐(TFLOP/s) |
|---|---|---|---|---|
| step21:A、B 共用加载函数 | 5707 万 | 2.069 亿 | 0.802 ms | 147.569 |
| step22:B 按寄存器对加载 | 198 万 | 1.520 亿 | 0.675 ms | 175.319 |
两版做了同样多的矩阵加载和乘加。光是让 B 按下一条指令需要的顺序落进寄存器,一次 GEMM 就少执行了约 5500 万条 IMAD.MOV.U32,吞吐从 147.6 涨到 175.3 TFLOP/s。
23–25. 平台期
到了 175 TFLOP/s 左右,我们开始遇到一个平台期,尝试各种“歪门邪道”。
step23 尝试让 A 使用普通 shared load,B 继续使用 ldmatrix。这个方向的想法是改变指令组合、给调度留空间。但我们这份实现中,拼出 A 所需的寄存器布局增加了工作,吞吐从 step22 的 175.319 降到 156.520 TFLOP/s。我们退回 step22。
step24 再尝试蛇形 MMA 顺序。假设一个 warp 要算四行、四列小块,普通顺序和蛇形顺序分别是:
普通顺序:                     蛇形顺序:
A0:B0 → B1 → B2 → B3          A0:B0 → B1 → B2 → B3
                                                ↓
A1:B0 → B1 → B2 → B3          A1:B0 ← B1 ← B2 ← B3
                                   ↓
A2:B0 → B1 → B2 → B3          A2:B0 → B1 → B2 → B3
                                                ↓
A3:B0 → B1 → B2 → B3          A3:B0 ← B1 ← B2 ← B3
蛇形让换到下一行时,第一条 MMA 仍然用上一条的 B,可能更有利于操作数复用。它改变的是执行这些独立输出块的顺序,K 的累加顺序没有因此改变。
step24 与 step22 都在约 0.675 ms、175.319 TFLOP/s,基本没有区别。B fragment 原来已经留在寄存器里,源代码层面也没有因此少加载一次 B。寄存器操作数的复用提示和硬件调度是否更合适,要看生成代码和实测。这次没有换来明显收益。
step25 换了个更小的改动:当前 tile 已经准备好了,为什么总要先发出远处 tile 的复制指令,再开始计算?把发起预取的位置往后挪半步试试。
step22:发起 tile(t+3) 的搬运 → 当前 K16_0 → 当前 K16_1 → 等待/同步
step25:当前 K16_0 → 发起 tile(t+3) 的搬运 → 当前 K16_1 → 等待/同步
只把已有预取放到两次 K16 之间。复制次数、MMA 次数、总动态指令数都不变,变化是它们出现的时间。未来 tile 的搬运也因此晚了半个 stage,要看当前计算能否从这个安排中获益。
耗时从 0.675 ms 降到 0.669 ms,吞吐从 175.3 提高到 176.8 TFLOP/s,提升约 0.9%。有收益,但不多。
这一阶段的 profile 是:Tensor pipe 约 57%,DRAM 约 21%,每 scheduler 有约 3.90 个 active warp、0.68 个 eligible warp。既不是 HBM 已经跑满,也不是“再加一个预取就能解决”。我们开始更多地检查 shared 加载、寄存器依赖和发射出来的辅助指令。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step22:三种尝试的基线 | 0.675 ms | 175.319 TFLOP/s |
| step23:A 用普通 shared load | 0.756 ms | 156.520 TFLOP/s |
| step24:蛇形 MMA | 0.675 ms | 175.319 TFLOP/s |
| step25:调整预取时机 | 0.669 ms | 176.821 TFLOP/s |
26–28. 继续碰壁
step26 又试了一次更大的 warp tile:从 64×32 变成 64×64。同一个 CTA 从八个 warp 变成四个,每个 warp 负责更多输出。
shared→register 的复用确实提高了。profile 中,ldmatrix 动态执行数从约 1084 万降到 723 万,总指令也减少。但每线程寄存器上升到 242,SM 上虽然仍能放两个 CTA,驻留的 warp 总数却从 16 降到了 8。每 scheduler 的 active warp 约从 3.9 降到 2.0,eligible warp 也减少,结果反而慢了。
但“warp 少了”也不是看到慢就能套用的解释。我们看过同一 shape 下 cuBLAS 的配置:大 tile,单 CTA 驻留,也能很快。它有不同的寄存器复用和指令安排。至少在我们这一版里,减少 shared 加载还没能补上减少 warp 的损失。
step27 换一个方向,把 K32 改为 K64。为了让输入 shared 总容量仍然是 64 KiB,四缓冲改成双缓冲:
原来:4 × [A 128×32 + B 128×32] × 2B = 64 KiB
现在:2 × [A 128×64 + B 128×64] × 2B = 64 KiB
输入总量相同,但每行从 64 B 变成 128 B,复制在 shared 端的组织不同了;stage 数也再次减半。XOR 映射要随行宽改变,不能直接把旧的二维数组第二维改成 64 就结束。
这一步在数据层面有实实在在的改善:
| 指标 | K32 / 四缓冲 | K64 / 双缓冲 |
|---|---|---|
LDGSTS 的 shared wavefront | 2890 万 | 1445 万 |
| 总动态 warp 指令 | 1.520 亿 | 1.421 亿 |
ldmatrix 与 HMMA 次数 | 相同 | 相同 |
但 K64 的四次 K16 计算增加了寄存器和调度压力,出现少量 spill;short-scoreboard 的每 issue-active 指标也从 0.81 升到了 1.62。正常运行没有超过 step25。
我们在 SASS 里还看到类似这样的片段:
LDSM  把新的 A fragment 放入寄存器
HMMA  紧接着使用这份 A
HMMA
HMMA
HMMA
LDSM  再加载下一份 A
HMMA  又立即使用它
这提示可以试着把下一份 A 提前。step28 因此在源码里安排两个 A fragment 槽:
先加载 A0
加载 A1 → 计算 A0
加载 A2 → 计算 A1
加载 A3 → 计算 A2
           计算 A3
但是源码写在前面,不等于最终机器指令一定保留了我们想象的距离。编译器会重新调度、分配寄存器;查看生成结果后,立即 load→use 的位置仍然存在。
step27 约 0.682 ms,step28 约 0.676 ms,吞吐提高约 0.8%;但 step25 只需要 0.669 ms,step28 仍比它慢约 1.0%。它改善了这个候选,却没有超越已经有的最好版本。
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step25:这几步的基线 | 0.669 ms | 176.821 TFLOP/s |
| step26:warp 64×64 | 0.793 ms | 149.284 TFLOP/s |
| step27:K64 / 双缓冲 | 0.682 ms | 173.634 TFLOP/s |
| step28:在 step27 上预取 A fragment | 0.676 ms | 175.054 TFLOP/s |
到这里,靠“再少搬一点”“再提前一点”都没能超过 step25。尤其是源码里的预取被编译器重新安排这件事,提醒我们该回到最终指令上看看了。
29. 最后的突破
GPT 最后注意到了 四个 buffer 的轮换。
旧版是这样轮换四个 shared buffer 的:
int read_buf = 0;
for (int k_base = 0; k_base < K; k_base += 32) {
    // 从 sA[read_buf]、sB[read_buf] 读取
    compute_first_k16();
    prefetch_far_tile();  // 预取第 t+3 块
    compute_second_k16();
    wait_and_sync();
    read_buf = (read_buf == 3) ? 0 : read_buf + 1;
}
K=2048,一共循环 64 轮。人一眼就能看到槽位永远是:
0 → 1 → 2 → 3 → 0 → 1 → 2 → 3 → ...
但旧代码只有一份循环体,read_buf 是跨迭代维护的运行时状态。比如 A 的一个槽占 128×32×2 = 8192 B,当前 shared 地址概念上是:
shared 起点 + read_buf × 8192 + 槽内位置
step20 在 WMMA 版本上去掉搬运里的边界判断后反而慢了,这次我们回到 step25 的手写 MMA 版本上再试一次。我们先为完整 tile 提供专用搬运路径:最终的快速路径要求 M、N、K 都是 128 的倍数,host 判断一次后,kernel 不必在每次向量复制里反复判断边界。这一步在 step25 上获得约 8.4% 的收益。
接着把四槽轮换显式组织成一个固定四轮的内层循环:
for (int k_outer = 0; k_outer < K; k_outer += 128) {  // 四个 K32 为一组
    #pragma unroll
    for (int read_buf = 0; read_buf < 4; ++read_buf) {  // 展开为四个固定槽
        const int k_base = k_outer + read_buf * 32;

        compute_first_k16();
        prefetch_far_tile();  // 预取第 t+3 块
        compute_second_k16();
        wait_and_sync();
    }
}
内层展开后,编译器看到的是四份使用固定槽号的代码:
外层第 0 轮:
  槽 0:算 K[  0, 32)  → 中途预取 tile3 到槽3
  槽 1:算 K[ 32, 64)  → 中途预取 tile4 到槽0
  槽 2:算 K[ 64, 96)  → 中途预取 tile5 到槽1
  槽 3:算 K[ 96,128)  → 中途预取 tile6 到槽2

外层第 1 轮:
  槽 0:算 K[128,160)
  槽 1:算 K[160,192)
  ...
槽偏移成为 0、8192、16384、24576 B 这些常数,相关地址计算更容易提前或消掉。外层循环从 64 轮变成 16 轮。这一步又把约 0.618 ms 降到 0.566 ms,在完整 tile 路径的基础上再提高约 9.1%。
再看执行出来的指令:
| 每次 GEMM 的动态 warp 指令 | step25 | step29 |
|---|---|---|
| 总数 | 151,972,128 | 87,790,752 |
| 分支类指令 | 13,660,416 | 5,080,320 |
地址与控制等辅助工作大幅减少,总指令数下降约 42.2%。
最后的结果是:
| 实现 | 耗时 | 吞吐 |
|---|---|---|
| step25 | 0.669 ms | 176.821 TFLOP/s |
| step29 | 0.566 ms | 208.976 TFLOP/s |
| cuBLAS | 0.487 ms | 243.175 TFLOP/s |
step29 比 step25 提高了 18.2%,我们终于达到了 200 TFLOP/s, 大约是 cuBLAS 的 85.9%。
后记
该内容主要来自于 GPT 带领我通过优化 GEMM 学习 CUDA 与 GPU 编程的回顾,由 AI 生成,个人润色。这本来应该是属于我计划仿照 cs336 的整个 AI infra (模型/训练/推理)中算子这一节的,希望有机会能完成整个教程/笔记吧。